

Enregistreur
L’enregistreur est conçu pour suivre les métriques clés de l’entraînement (y compris les métriques distribuées avec des réductions et des temps), ainsi que pour fournir une intégration avec des backends de journalisation comme WandB, Tensorboard et MLflow.
Exigences
- Suivi des métriques distribuées avec des réductions spécifiées (moyenne, maximum, etc.)
- Suivi des temps distribués avec réduction (généralement) ‘max’ sur les rangs
- Journalisation :
- WandB
- Tensorboard
- MLflow
Conception globale
Comme il n’y a qu’un seul contrôleur, le processus unique exécutant la boucle d’entraînement principale rassemblera les métriques et effectuera la journalisation.
Pour gérer plusieurs backends d’enregistreurs, nous aurons une interface LoggerInterface que TensorboardLogger, WandbLogger et MLflowLogger implémenteront :
Une classe d’enveloppe Logger implémentera également LoggerInterface et maintiendra une liste d’enregistreurs auxquels elle déléguera l’écriture des journaux. Ce sera la classe principale que l’utilisateur utilisera dans la boucle d’entraînement. Exemple d’utilisation :
Backends de journalisation pris en charge
L’enregistreur prend en charge trois backends de journalisation principaux :
WandB (Weights & Biases)
- Fournit un suivi d’expérience basé sur le cloud
- Prend en charge les métriques d’étape personnalisées pour une meilleure visualisation
- Inclut la journalisation des paramètres hyper intégrée
- Offre des fonctionnalités de visualisation et de collaboration riches
Tensorboard
- Journalisation basée sur des fichiers locaux
- Visualisation TensorBoard standard
- Prend en charge la journalisation des paramètres hyper via HParams
- Léger et autonome
MLflow
- Plateforme complète pour le suivi d’expérience et la gestion de modèles
- Prend en charge les serveurs de suivi locaux et distants
- Fournit le versionnage de modèles et la gestion d’artefacts
- Inclut une interface web pour la visualisation d’expérience
- Prend en charge le déploiement et la diffusion de modèles
Configuration de MLflow
MLflow peut être configuré avec les paramètres suivants :
Interface utilisateur de MLflow
Après avoir démarré l’entraînement avec MLflow activé, vous pouvez afficher l’interface utilisateur de MLflow pour surveiller vos expériences :
Puis accédez à l’interface à l’adresse http://127.0.0.1:5000/ pour afficher :
- Exécutions et expériences d’entraînement
- Métriques (perte, métriques de validation, etc.)
- Paramètres hyper
- Artefacts et points de contrôle de modèle
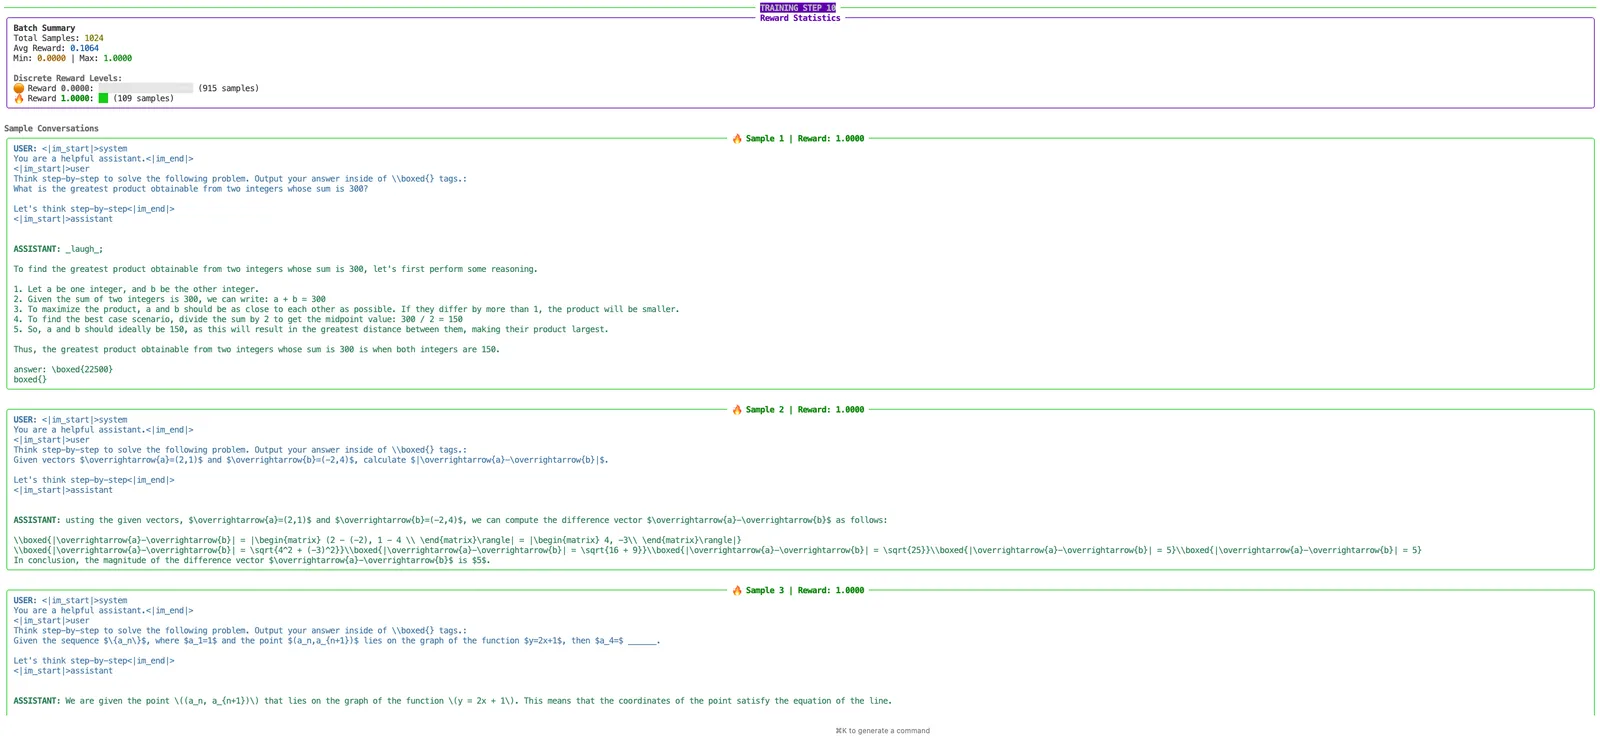
Journalisation jolie de validation
L’enregistreur prend en charge la journalisation formatée des échantillons de validation pour aider à visualiser les sorties du modèle pendant l’entraînement. Cette fonctionnalité est contrôlée par le paramètre de configuration num_val_samples_to_print.
Lorsque num_val_samples_to_print est défini à une valeur supérieure à 0, l’enregistreur générera des sorties texte bien formatées pour le nombre spécifié d’échantillons de validation. Ceci est particulièrement utile pour :
- Inspecter rapidement la qualité de génération du modèle pendant l’entraînement.
- Comparer les entrées et les sorties côte à côte.
- Suivre les performances des échantillons de validation au fil du temps.
Exemple de sortie
Lorsqu’elle est activée, la journalisation jolie générera un texte formaté similaire à :
Journalisation des métriques GPU
NeMo RL surveille la mémoire et l’utilisation du GPU via les métriques système exposées par les nœuds Ray. Bien que Ray rende ces métriques disponibles pour des outils comme Prometheus, NeMo RL interroge directement les données de mémoire et d’utilisation du GPU et les enregistre dans TensorBoard, WandB et/ou MLflow.
Cette approche nous permet d’offrir le même suivi des métriques GPU sur tous les enregistreurs et simplifie grandement l’implémentation.
Cette fonctionnalité est activée avec le paramètre de configuration monitor_gpus. La fréquence de collecte de données et de vidage dans les enregistreurs est contrôlée par les paramètres gpu_collection_interval et gpu_flush_interval, tous deux spécifiés en secondes.
Bien qu’il soit possible de surveiller à l’aide de workers distants, l’implémentation nécessite une attention particulière aux détails pour assurer :
- Les journaux renvoyés au pilote n’introduisent pas de surcharge significative.
- Les métriques restent claires et interprétables, évitant des problèmes comme le double comptage causé par des workers co-localisés.
- Les workers peuvent vider leurs journaux de manière transparente en cas de défaillance.
- La journalisation se comporte de manière cohérente sur TensorBoard, WandB et MLflow.
- Les workers qui génèrent d’autres workers signalent précisément l’utilisation totale des ressources de tout worker petit-fils.
En raison de ces complexités, nous avons opté pour une approche plus simple : collecter les métriques exposées par le serveur de métriques Ray à partir du pilote.