

SFT sur OpenMathInstruct-2
SFT sur OpenMathInstruct-2
Ce guide explique comment utiliser NeMo RL pour exécuter SFT sur le jeu de données d’instruction mathématique nvidia/OpenMathInstruct-2. Nous montrerons ensuite comment utiliser les scripts d’évaluation de NeMo RL pour évaluer le modèle entraîné sur le benchmark MATH-500.
Entraîner le Modèle
Pour entraîner le modèle à l’aide de NeMo RL, utilisez le fichier de configuration examples/configs/recipes/tutorials/sft/sft_openmathinstruct2.yaml. Ce fichier correspond de près aux paramètres d’expérience dans le document original OpenMathInstruct-2.
Splits du Jeu de Données
OpenMathInstruct-2 dispose de plusieurs versions de différentes tailles. Configurez la version du jeu de données via la configuration data.split :
train: 14 M de paires problème-solution complètestrain_1M,train_2M,train_5M: sous-ensembles sous-échantillonnés de manière équitable de 1M, 2M ou 5M d’exemples
Par défaut, la configuration utilise le sous-ensemble de 1M (data.split=train_1M).
Temps d’Entraînement
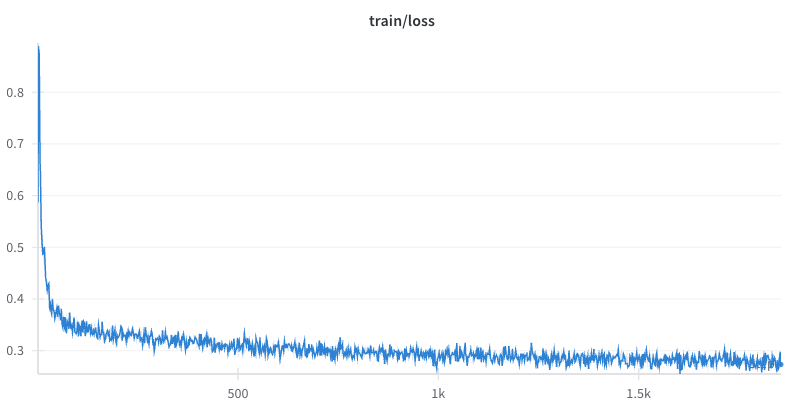
La configuration par défaut utilise 8 GPU (cluster.gpus_per_node) sur 1 nœud (cluster.num_nodes), ce qui devrait terminer 1 époque d’entraînement pour le jeu de données train_1M (1855 étapes) en environ 20 heures. Des nœuds supplémentaires peuvent être utilisés pour accélérer l’entraînement. Nous avons constaté dans nos expériences qu’en utilisant 8 nœuds, nous pouvons terminer 1 époque d’entraînement pour le jeu de données train_1M en moins de 4 heures.
Évaluer le Modèle
Tout au long de l’entraînement, les points de contrôle du modèle seront enregistrés dans le dossier results/sft_openmathinstruct2 (spécifié par checkpointing.checkpoint_dir). Pour évaluer le modèle, nous devons d’abord convertir le point de contrôle distribué PyTorch au format Hugging Face :
Remplacez results/sft_openmathinstruct2/step_1855 par le chemin du point de contrôle que vous évaluez. Le point de contrôle Hugging Face résultant sera enregistré dans --hf-ckpt-path.
Pour évaluer sur le benchmark MATH-500, utilisez la commande suivante :
Utilisez generation.model_name pour spécifier le chemin du point de contrôle Hugging Face.
Résultats
Dans cette section, nous présentons les résultats de plusieurs expériences de référence pour les versions train_1M et train du jeu de données.
train_1M
En utilisant les instructions ci-dessus pour entraîner un modèle Llama-3.1-8B pendant 1 époque sur la version train_1M du jeu de données OpenMathInstruct-2, nous obtenons la courbe de perte suivante :
En évaluant le point de contrôle final sur MATH-500, nous obtenons le résultat suivant :
À titre de référence, en utilisant NeMo-Aligner et NeMo-Skills (comme dans le document original OpenMathInstruct-2) pour entraîner et évaluer le même modèle sur le même jeu de données, on obtient le même score de 0.5020 sur MATH-500.
train
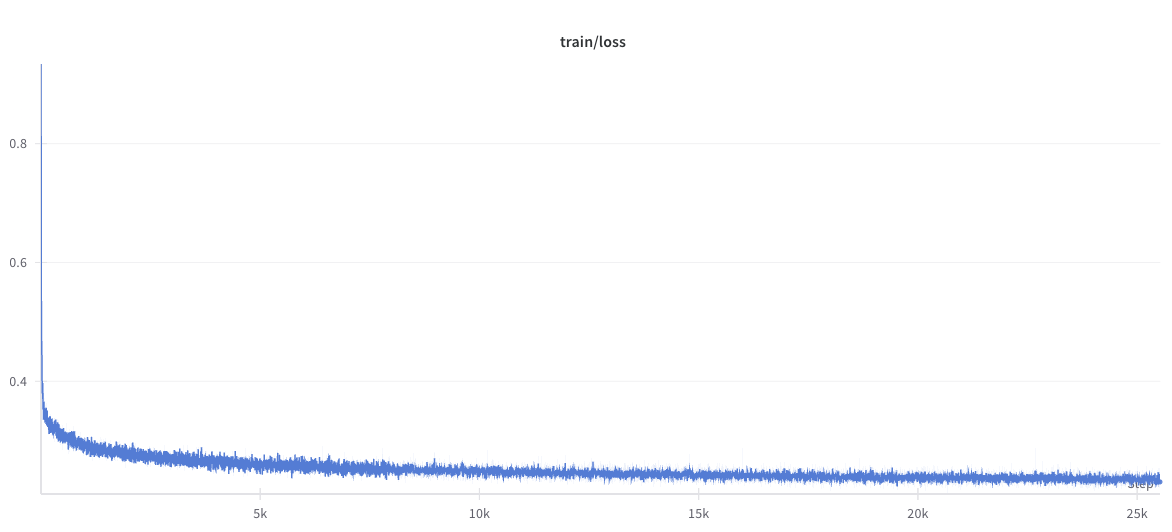
Nous avons également entraîné un modèle Llama-3.1-8B pendant 1 époque sur la version complète train du jeu de données OpenMathInstruct-2. Nous obtenons la courbe de perte suivante :
En évaluant le point de contrôle final sur MATH-500, nous obtenons le résultat suivant :
En utilisant NeMo-Aligner et NeMo-Skills pour entraîner le modèle dans les mêmes paramètres, on obtient un score de 0.6140 (307/500).
À titre de référence supplémentaire, en utilisant un point de contrôle après 10 000 étapes d’entraînement avec NeMo-RL, on obtient un score de 0.5800 (290.0/500).